


AI Video Assistant
Leistungen:
- Produktdesign
- Full-Stack-Entwicklung
- KI-Engineering (RAG)
- Videoverarbeitungs-Pipeline
- Mandantenfähige SaaS-Architektur
Branche:
- Medizinische Weiterbildung · Berufliche Fortbildung · SaaS
Technologie:
- Angular 21
- NestJS / TypeORM
- PostgreSQL 16 + pgvector
- OpenAI GPT & Embeddings
- Google Gemini
- PyannoteAI-Diarisierung
- Vimeo API, ffmpeg
- Tailwind CSS, Bun, Supabase
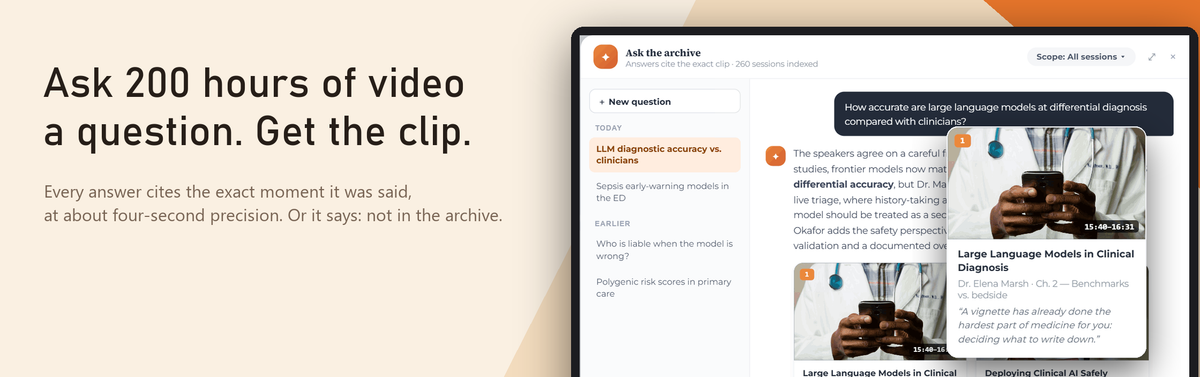
Jemand fragt Sie, wie genau Sprachmodelle bei der Differenzialdiagnose sind. Sie wissen, dass ein Referent darüber gesprochen hat. War es der Frühjahrsgipfel oder das Radiologie-Panel? Nach vierzig Minuten oder nach zehn? Früher haben Sie die Aufnahme geöffnet und gespult. Heute tippen Sie die Frage ein und bekommen eine Antwort in zwei Absätzen und zwei Clips, gesetzt auf 15:40 und 21:08, wo die Referenten es tatsächlich gesagt haben. Hat es niemand gesagt, sagt Ihnen das Archiv genau das, statt etwas zu erfinden.
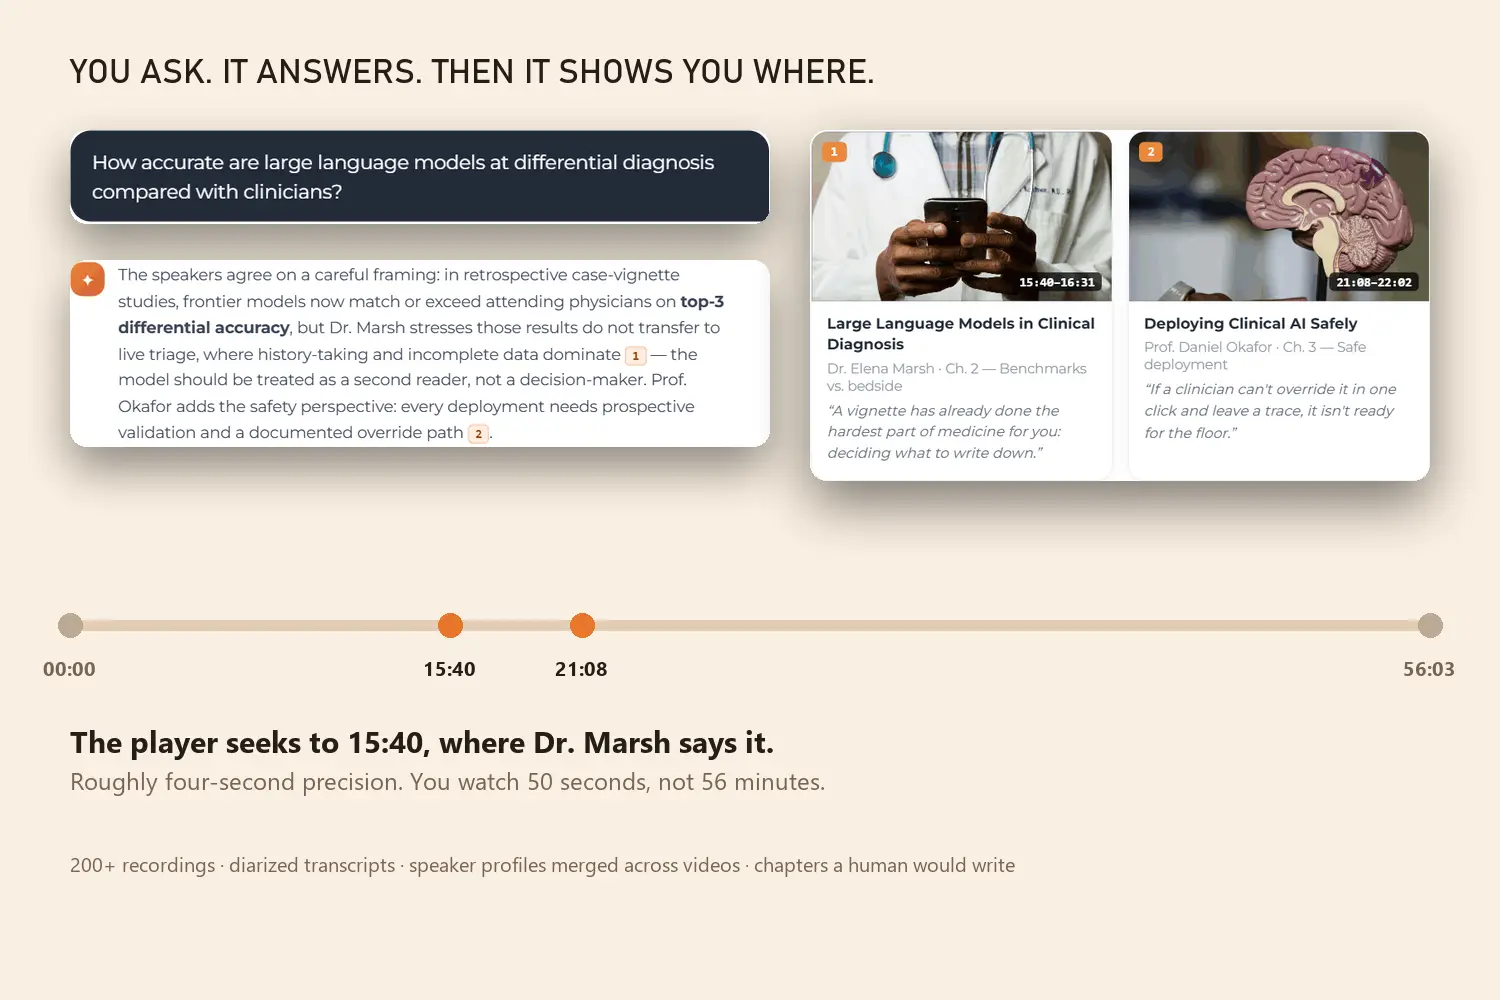
Sie fragen. Es antwortet. Und zeigt Ihnen, wo. Jede Aufnahme kommt mit einem Transkript, das weiß, wer spricht, mit einem Sprecherprofil, das dieselbe Person über Dutzende Videos hinweg zusammenführt, und mit einer Kapitelliste, die Ihnen in zehn Sekunden sagt, ob eine einstündige Session Ihre Zeit wert ist. Stellen Sie eine Frage, kommt die Antwort mit nummerierten Quellenangaben; ein Klick, und der Player springt zu dem Moment, in dem der Punkt gemacht wurde, auf etwa vier Sekunden genau. Tippen Sie @, um einen Referenten zu fragen, @@ für eine Session, oder fragen Sie, wie sich die Sicht eines Referenten auf ein Thema über Jahre von Vorträgen entwickelt hat.
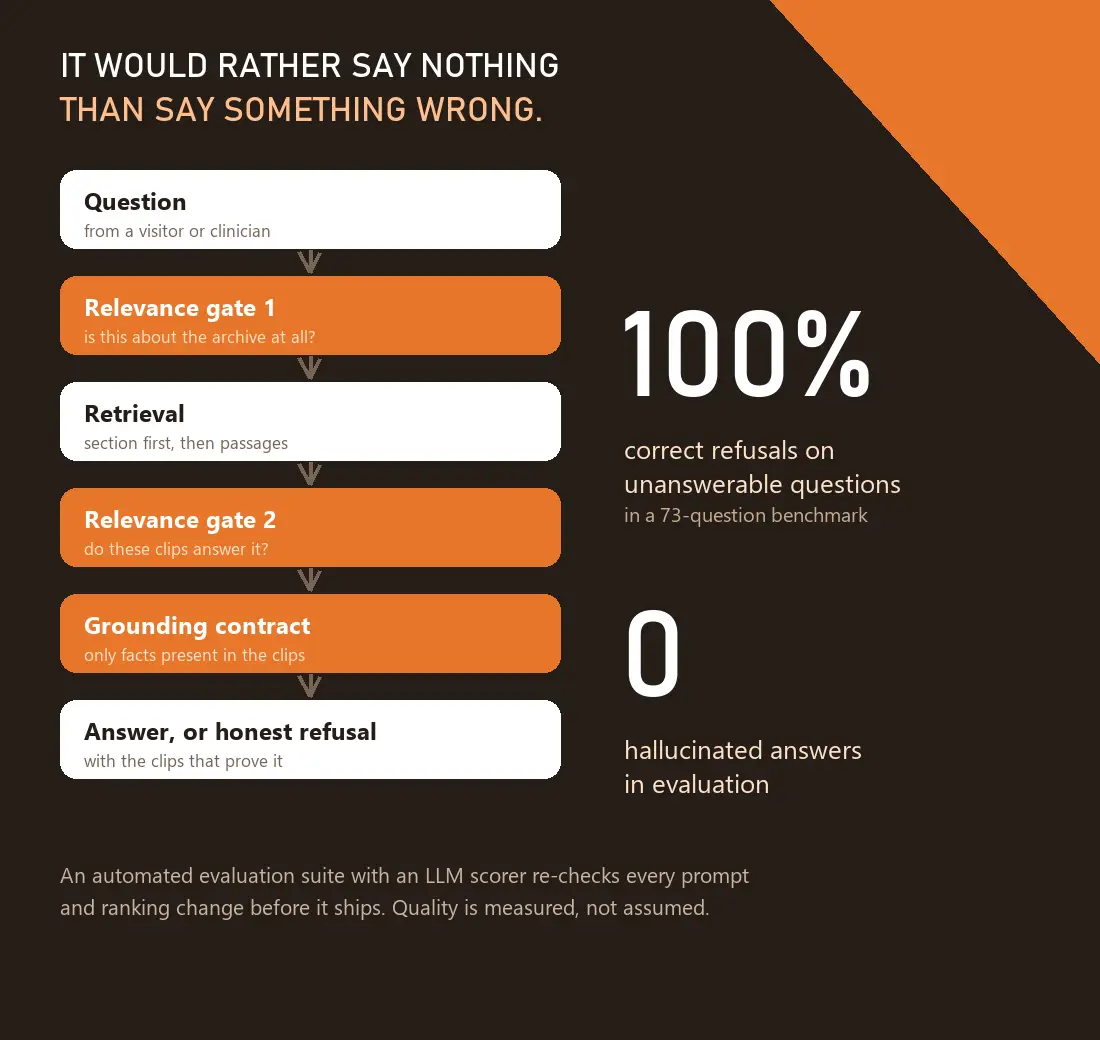
Lieber nichts sagen als etwas Falsches. In einem regulierten Feld ist eine selbstsichere falsche Antwort schlimmer als keine, deshalb ist das System auf Absagen ausgelegt. Zwei Relevanzprüfungen stoppen themenfremde Fragen, bevor überhaupt ein Modell aufgerufen wird. Die Suche läuft erst nach Abschnitten, dann Passage für Passage, damit die Antwort aus dem richtigen Teil des richtigen Vortrags kommt. Ein strenger Grounding-Vertrag erlaubt nur Fakten, die in den gefundenen Clips vorkommen. Im Benchmark mit 73 Fragen lehnte das System jede unbeantwortbare Frage ab, statt zu raten, und eine automatisierte Evaluations-Suite mit einem LLM als Bewerter prüft jede Prompt- und Ranking-Änderung erneut, bevor sie live geht.
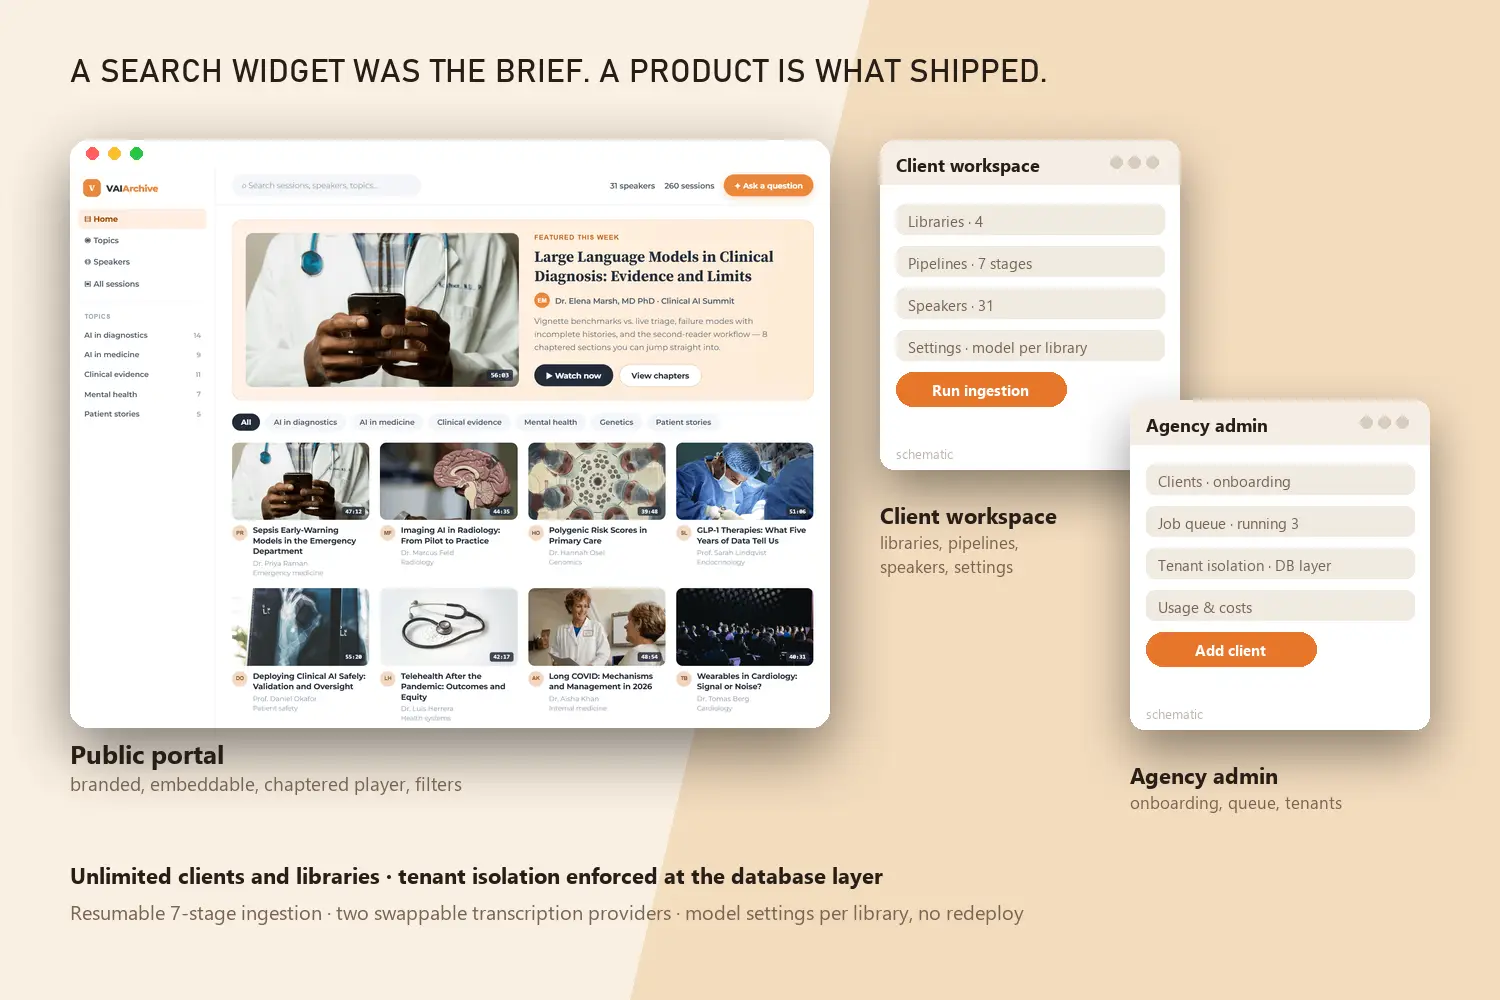
Bestellt war ein Such-Widget. Geliefert wurde ein Produkt. Ein gebrandetes öffentliches Portal mit eingebettetem Player, Kapitelnavigation, Filtern, eigenem CSS und einer Domain-Freigabeliste fürs Einbetten. Ein Kundenbereich für Bibliotheken, Pipelines, Sprecher und Einstellungen. Ein Admin-Bereich für die Agentur, um Kunden anzulegen und die Job-Warteschlange zu überwachen. Darunter eine wiederaufnehmbare Ingestion-Pipeline in sieben Stufen mit zwei austauschbaren Transkriptionsanbietern und Modelleinstellungen pro Bibliothek: Die Qualität wird ohne neues Deployment justiert. Unbegrenzt viele Kunden und Bibliotheken, Mandantentrennung auf Datenbankebene: Aus einem passiven Archiv wurde ein Wert, den die Organisation branden, einbetten und für neue Zielgruppen öffnen kann.
Wenn das nach Ihrer Organisation klingt: Sie zeichnen alles auf, und niemand schaut es sich je wieder an. Wir bringen es dazu, Fragen zu beantworten – mit Belegen.
Lass uns anfangen!

