


AI Legal Assistant
Leistungen:
- Product Discovery
- UX/UI-Design
- Full-Stack-Entwicklung
- KI-Engineering
- Datenpipeline & Deployment
Branche:
- Menschenrechte · Legal Tech · Non-Profit
Technologie:
- Angular 21
- NestJS / TypeScript
- MariaDB
- OpenAI
- LangChain
- Google Sign-In
- Google Sheets API
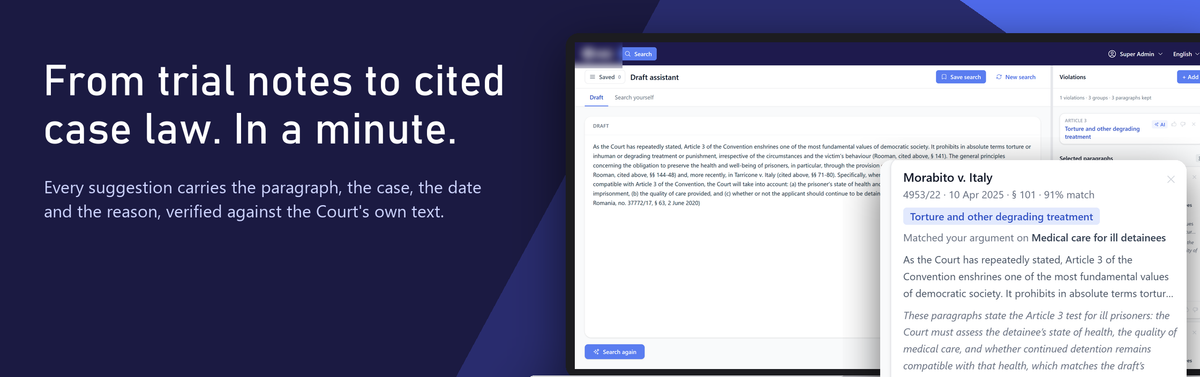
Sie verlassen den Gerichtssaal mit drei Seiten Notizen, und der Bericht ist morgen fällig. Irgendwo in 27.000 Absätzen der Rechtsprechung des Europäischen Gerichtshofs für Menschenrechte steht der Satz, der aus dem Gesehenen einen Vorwurf macht, den ein Richter ernst nimmt. Sie fügen Ihre Notizen ein. Etwa eine Minute später nennt der Assistent die Verletzungen, auf die sie hindeuten, und liefert die zu zitierenden Absätze, jeder Wort für Wort geprüft an der Datenbank des Gerichtshofs.
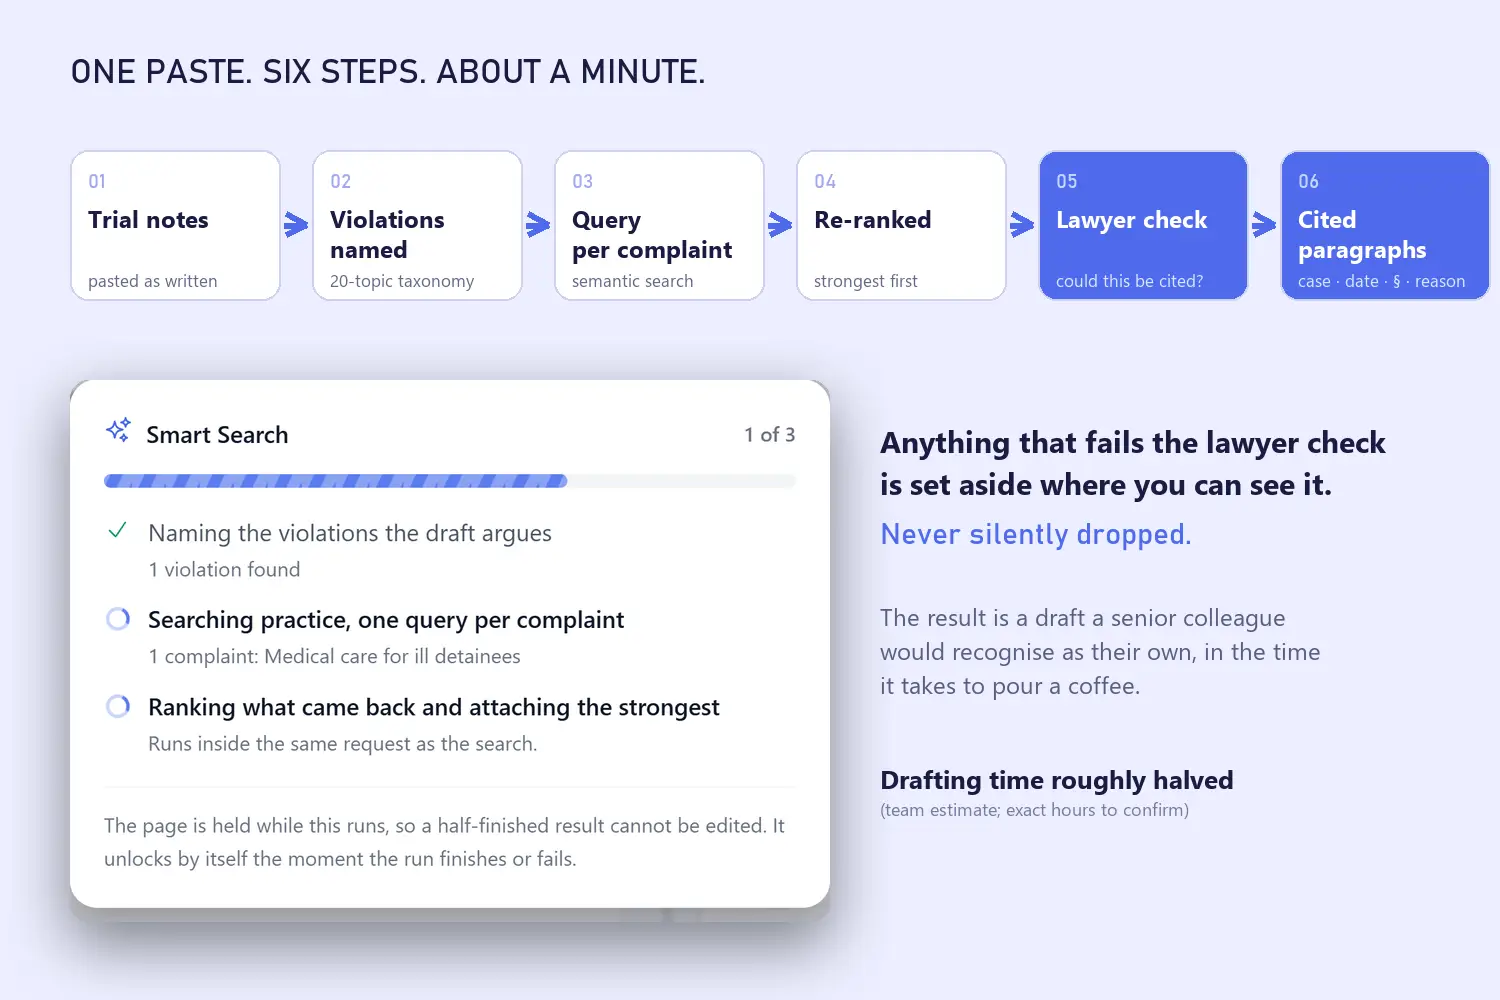
Einmal einfügen, etwa eine Minute warten, nichts Erfundenes. Der Assistent liest Ihre Notizen so, wie Ihre Juristen es tun würden. Er benennt die Verletzungen nach der eigenen Taxonomie der Organisation mit 20 Themen, teilt den Text in einzelne Beschwerden auf, durchsucht jede semantisch und sortiert die Treffer neu. Dann stellt er die einzige Frage, die zählt: Könnte ein Jurist diesen Absatz für diese Beschwerde ehrlich zitieren? Was durchfällt, wird sichtbar beiseitegelegt, nie stillschweigend verworfen. Jeder Vorschlag kommt mit dem vollständigen Absatz, dem Fall, dem Datum und einer einzeiligen Begründung in Ihrer Sprache. Nach Einschätzung des Teams hat sich die Zeit für einen Berichtsentwurf ungefähr halbiert.
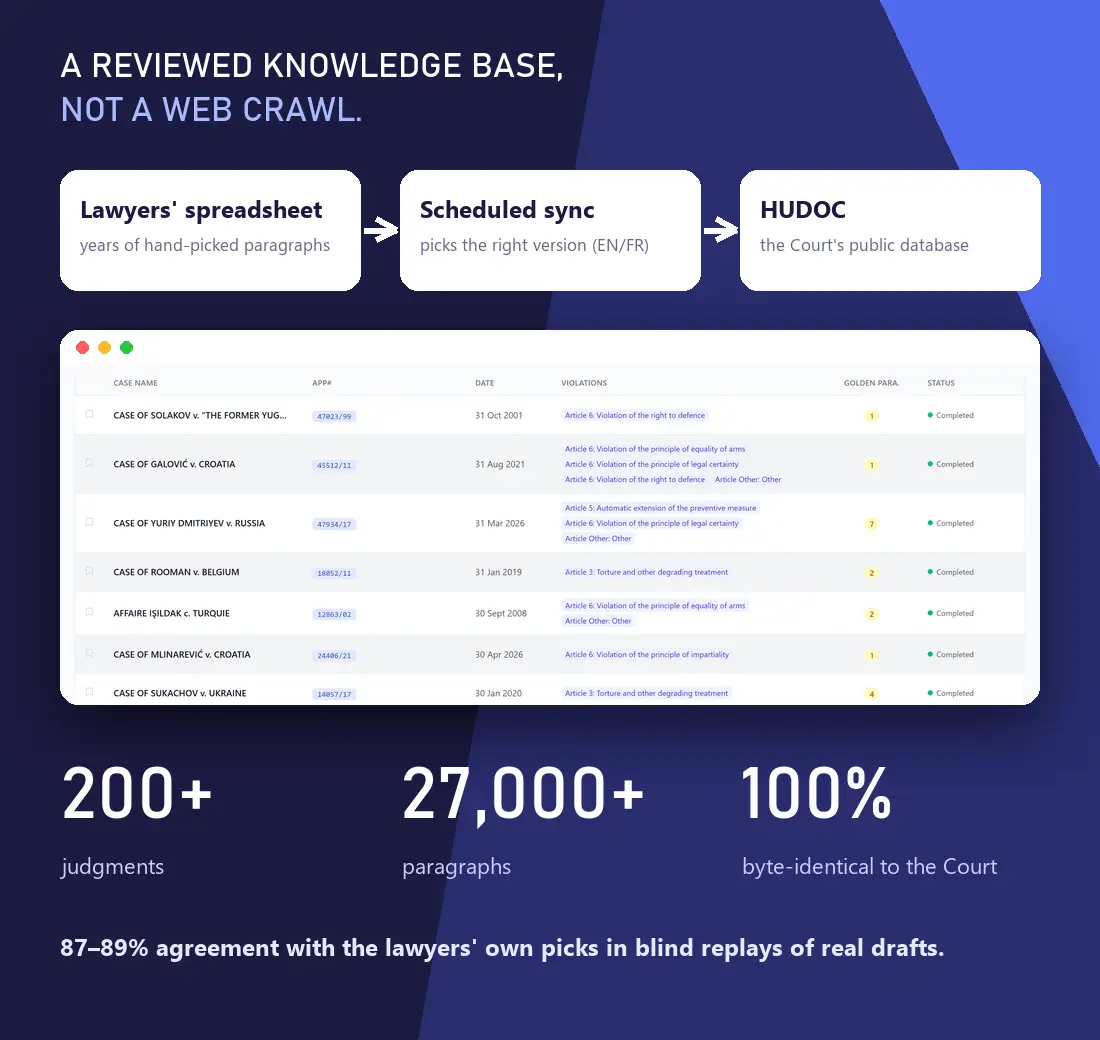
Eine geprüfte Wissensbasis, kein Web-Crawl. Die Tabelle der erfahrenen Juristen wurde zur verlässlichen Grundlage. Eine geplante Synchronisation liest ihre geprüften Zuordnungen, lädt jedes Urteil aus HUDOC, wählt die richtige Fassung, wenn eine Beschwerdenummer mehrere hat (Kammer, Große Kammer, englisches und französisches Original), und speichert genau die Absätze, die sie zitiert haben. Der Bestand umfasst 200+ Urteile und 27.000+ Absätze, und jeder zitierte Absatz ist byte-genau identisch mit dem veröffentlichten Text des Gerichtshofs. In Blindtests mit echten Entwürfen stimmte der Assistent in 87–89 % der Fälle mit der Auswahl der Juristen überein.
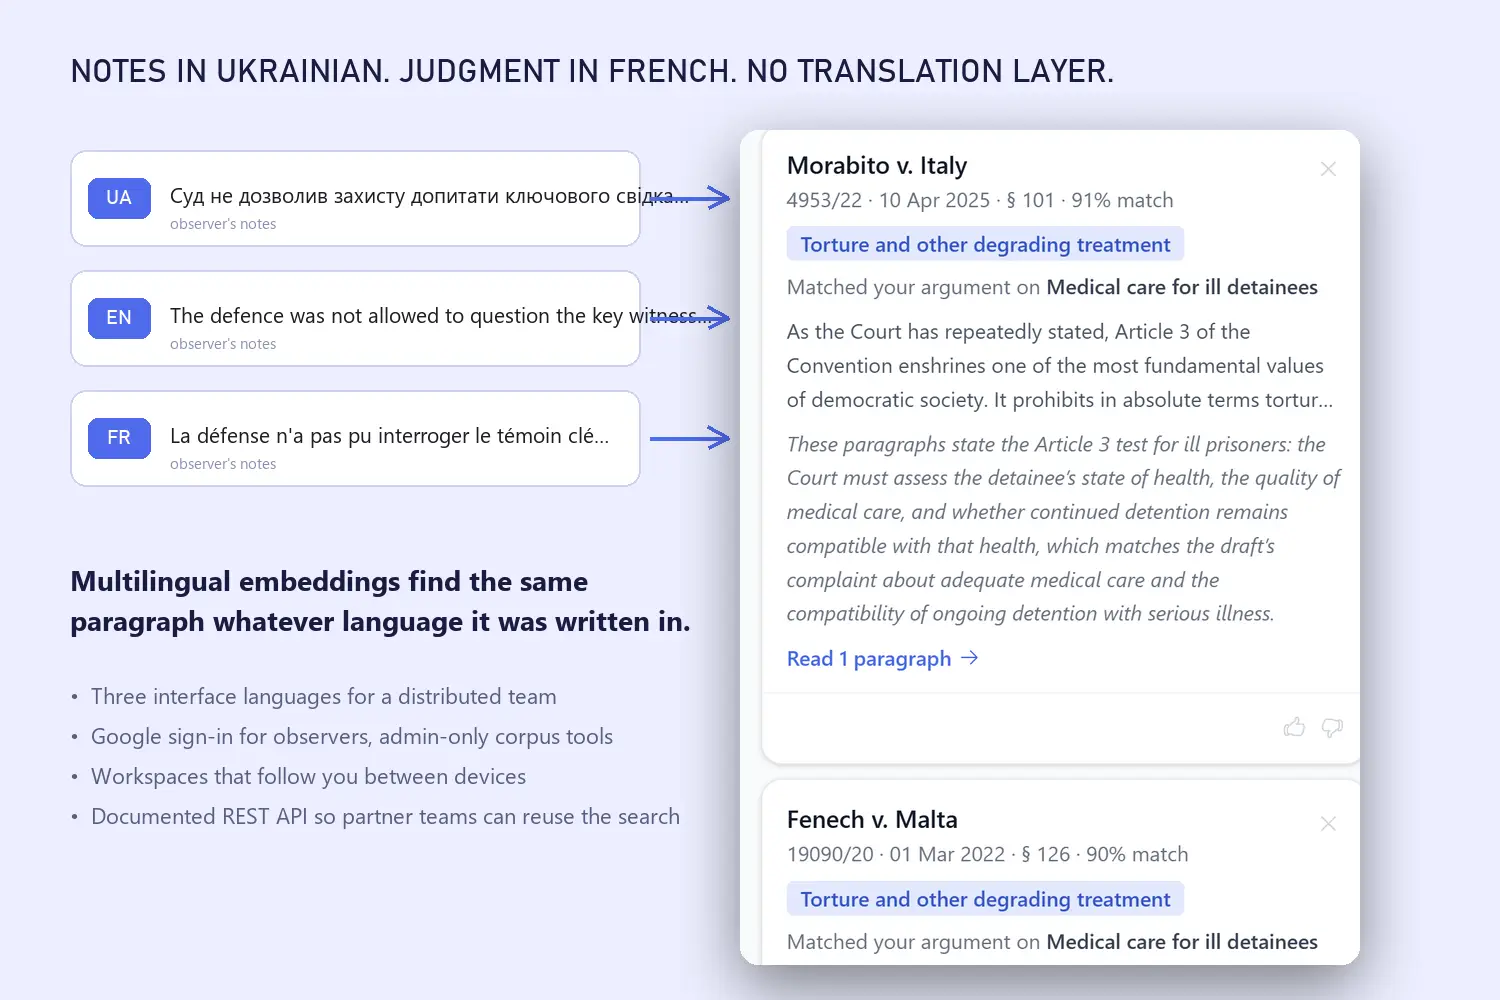
Jede Sprache rein, das richtige Urteil raus. Die Beobachter schreiben auf Ukrainisch, der Gerichtshof auf Englisch und Französisch. Mehrsprachige Embeddings finden denselben Absatz, egal in welcher Sprache er geschrieben wurde – es gibt also keinen Übersetzungsschritt, der Fehler einschleppt. Drei Oberflächensprachen, Google-Anmeldung für Beobachter, Zugriff auf Bestand und Taxonomie nur für Administratoren, Arbeitsbereiche, die Ihnen von Gerät zu Gerät folgen, und eine dokumentierte REST-API, über die Partnerteams dieselbe Suche in ihre eigenen Agenten einbinden.
Wenn das nach Ihrem Team klingt: Expertenwissen, das wenige Menschen im Kopf oder in ihren Tabellen tragen, und alle anderen warten auf sie. Wir machen daraus ein Werkzeug, dem das ganze Team vertrauen kann.
Lass uns anfangen!

